概述
版本
| 服务器版本 | 功能变更 |
|---|---|
| 小乐AI-v8.1.0 | 前台过滤器支持组件引用全局数据时调用 |
后台过滤器
支持对经过参数过滤的数据源数据进行进一步的后台处理,例如聚合、排序。
聚合
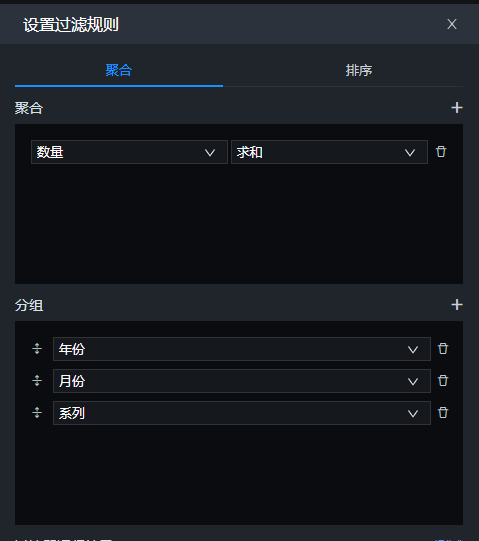
支持对数据字段进行分组和聚合处理,一般情况下会将除聚合字段外的所有字段进行分组,防止异常情况。用户也可以根据实际情况进行更改。支持的聚合方式有:求和、平均值、最大值、最小值、计数。
- 往往存在聚合字段就会存在分组字段,反之亦然,否则将会警告提示;。
- 字符型字段聚合时,如果数据类型不符聚合方式会强转:
- sum/avg:强转为数值型;
- max/min:
- 先尝试转数值,如果不行再转日期;
- 如果都不成功,无法聚合,此时分组内此字段的聚合值会为空。
例:
想通过基础柱状图呈现2020年和2021年的销售额数据。数据中是2020年和2021年各个月份的销售额明细:
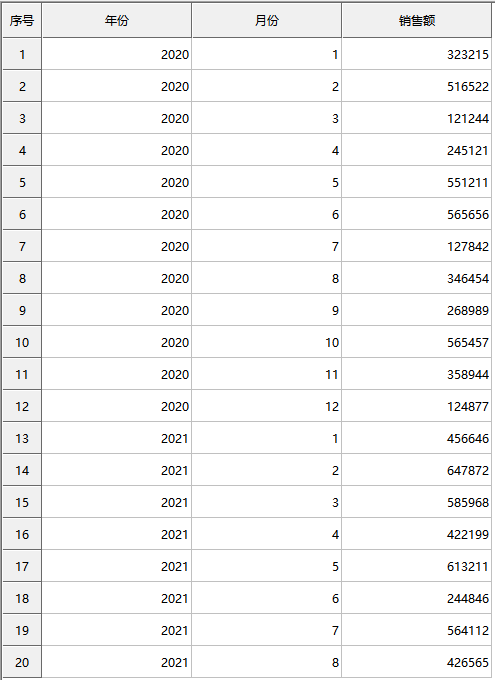
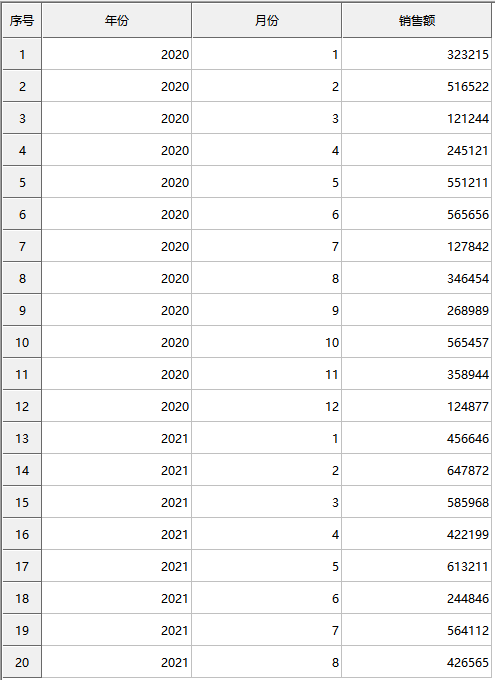
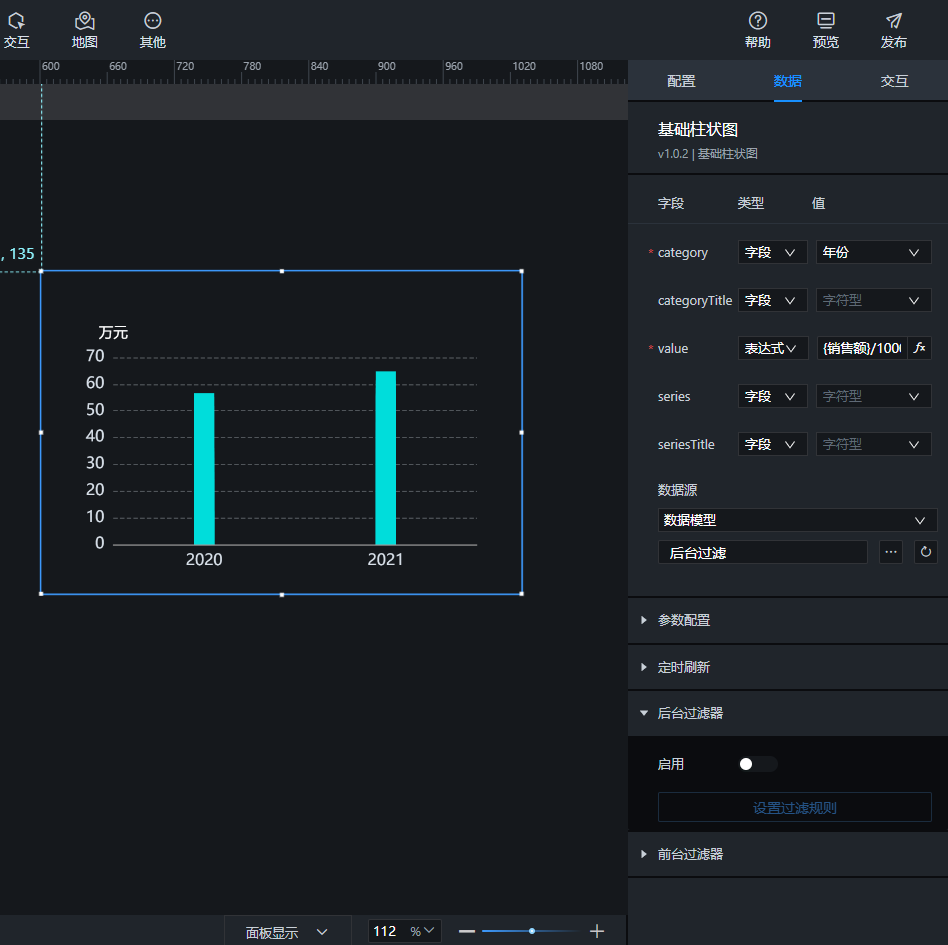
如果直接选择字段,则是按每年的第一个月份数据进行显示,不符合预期。
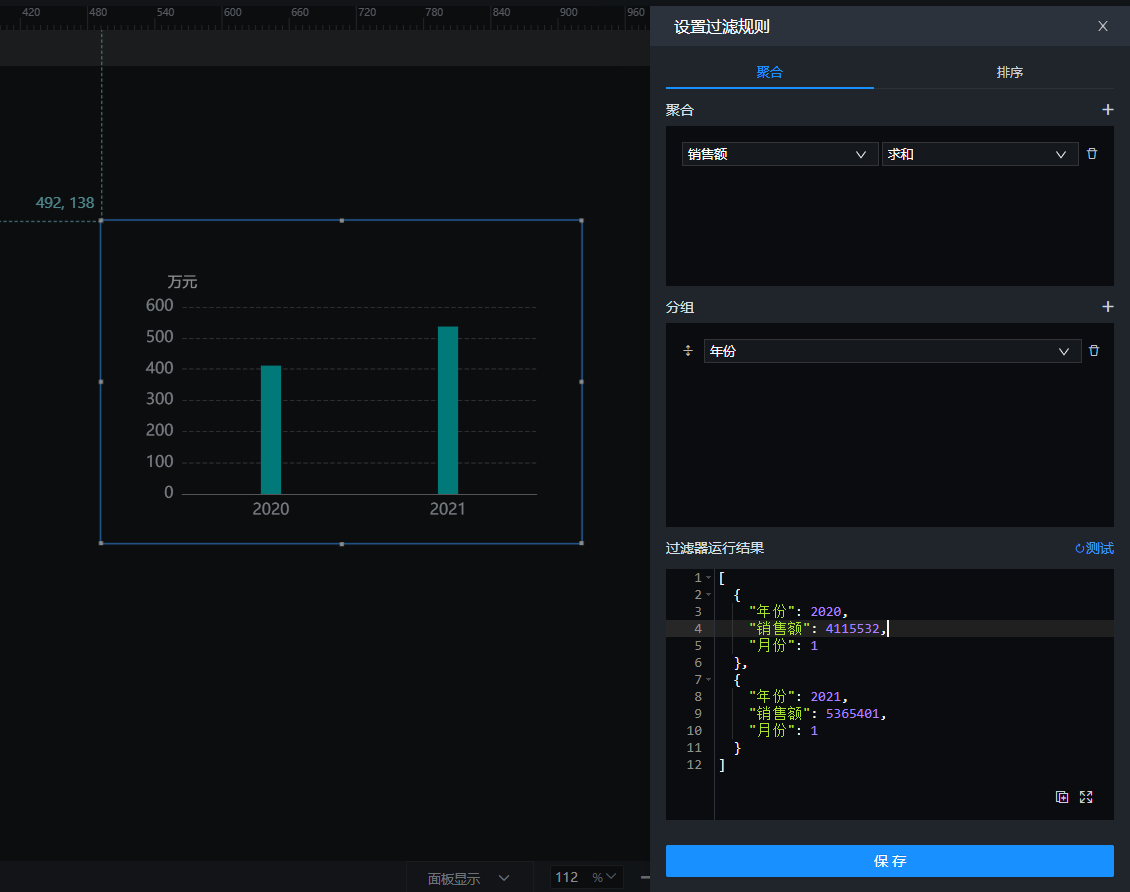
我们可以通过后台过滤器,按年份分组对销售额字段求和,即可将每个年份下的月份明细求和汇总。
后台过滤分组求和:
排序
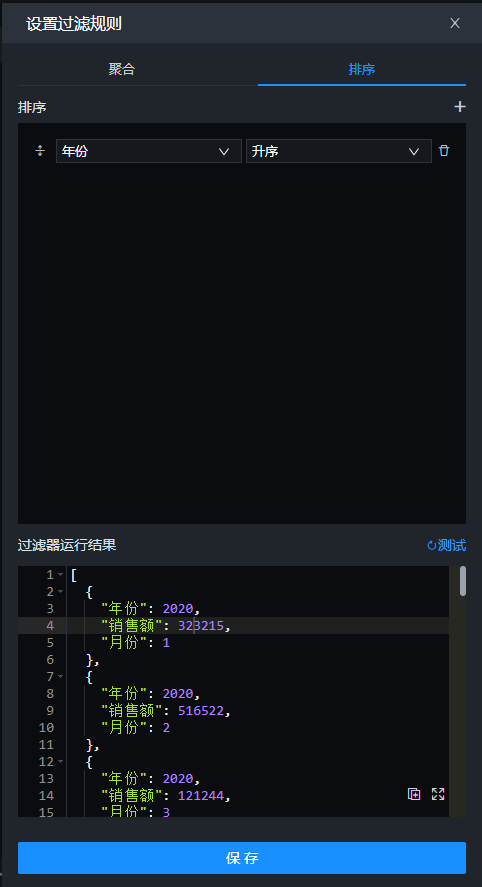
可通过添加排序字段,让数据返回顺序按需求变化。
年份升序:
年份降序:
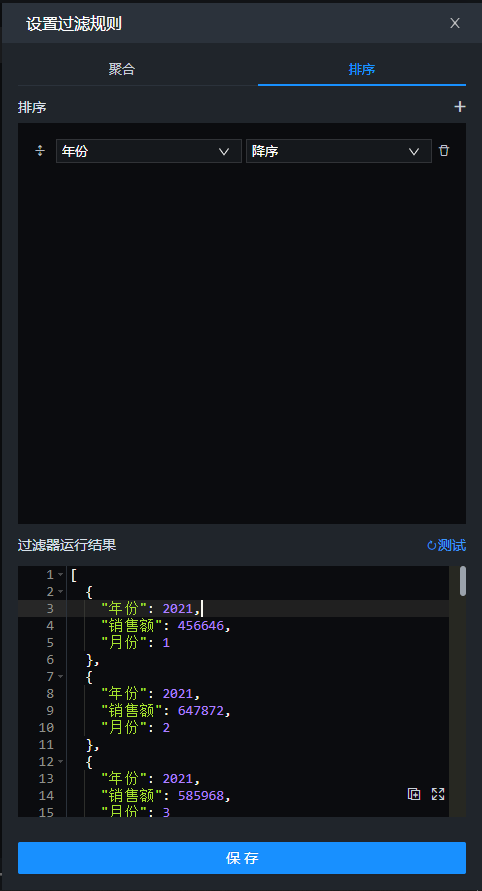
过滤器运行结果(只读)
点击测试,可以查看如果按当前配置处理数据将返回的数据结果。支持复制和全屏。
测试时配置并未保存,还是可以恢复修改前的配置的,操作更合理科学。当确认结果无误时再点击保存即可。
前台过滤器
场景
前台过滤器是LczMatrix提供的脚本编辑器,纯原生JS编辑器。
数据源数据经过参数过滤、后台过滤后,若仍需进行一些格式处理或逻辑计算,则可在后台过滤器返回结果的基础上再进行前台过滤处理。
面临非标准的数据接入场景时,例如通过数据源获取数据后,如果数据不符合组件所需的数据格式,就可以通过前台过滤器处理成符合需求的数据格式。对于数据结构和处理逻辑都相同的数据,还支持配合全局JS定义功能,在组件前台过滤器调用,后期即可统一维护。
目前全局过滤器支持全局数据、组件引用全局数据、组件引用数据模型时进行调用,若引用了全局数据先处理全局数据的前后台过滤,在处理组件的前台过滤。
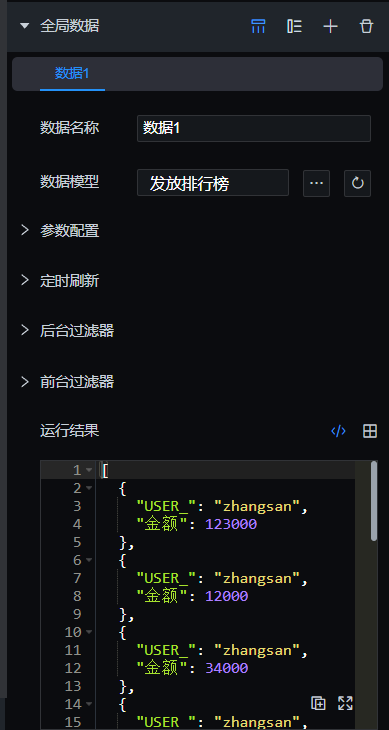
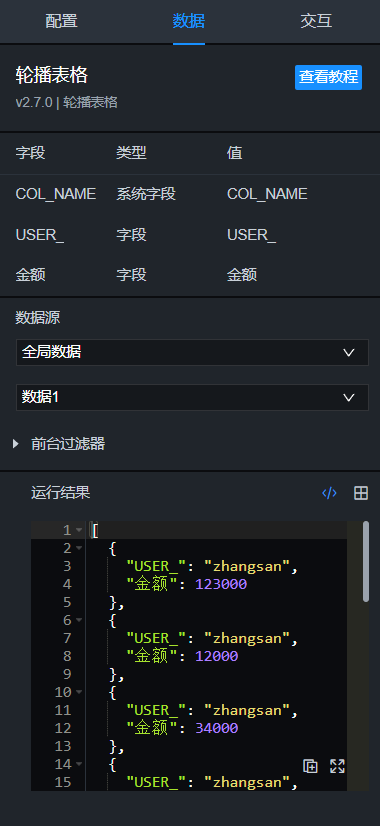
脚本编辑器
前台过滤器本质上是一个函数,包含固定参数 data 和 global。
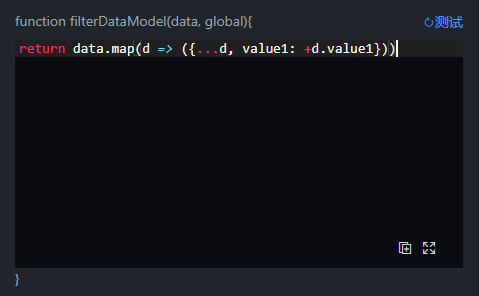
- 数据模型配置前台过滤时,data 为数据经过参数和后台过滤后得到的数据;
- 组件选择大屏数据后前台过滤时,data为大屏数据经过参数、后台过滤、前台过滤后得到的数据,即组件引用大屏数据后可以对结果进行再加工(二次前台过滤),以实现组件引用相同数据源,但仅有微小地方的处理有不同时的场景使用;
- global包含前台过滤器接收的回调参数(所有的大屏变量、用户变量……,在脚本中通过global.大屏变量名称进行使用);
- return 所返回的值将是组件获取的最终数据结果。
过滤器输入数据
提供对过滤器初始获取的data数据进行查看的能力,以便于更好地根据数据情况处理数据,也便于与“过滤运行结果”数据对比分析。
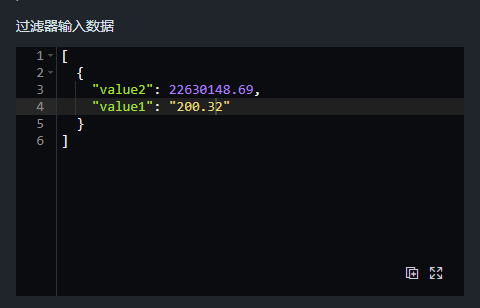
过滤器运行结果
点击测试,可以查看数据经过当前前台过滤脚本处理后将得到的结果。
测试时配置并未保存,还是可以恢复修改前的配置的,操作更合理科学。当确认结果无误时再点击保存即可。
当过滤结果为空数据时,最终运行结果将显示为原数据
举例
1. 字段类型转换
翻牌器value字段要求是数值型数据,当数据源返回字段为字符型时,可以通过前台过滤器进行类型转换处理。
return data.map(d => ({...d, value1: +d.value1}))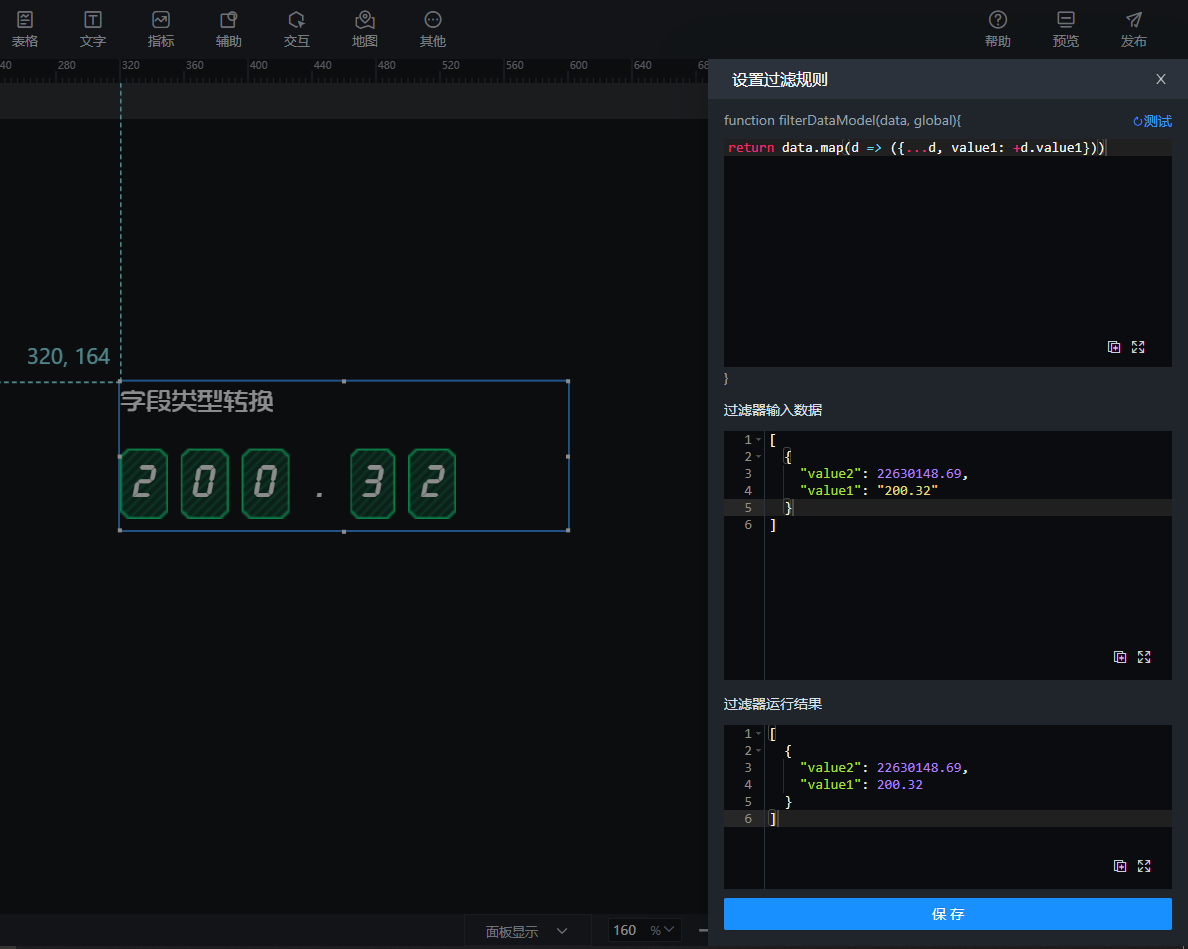
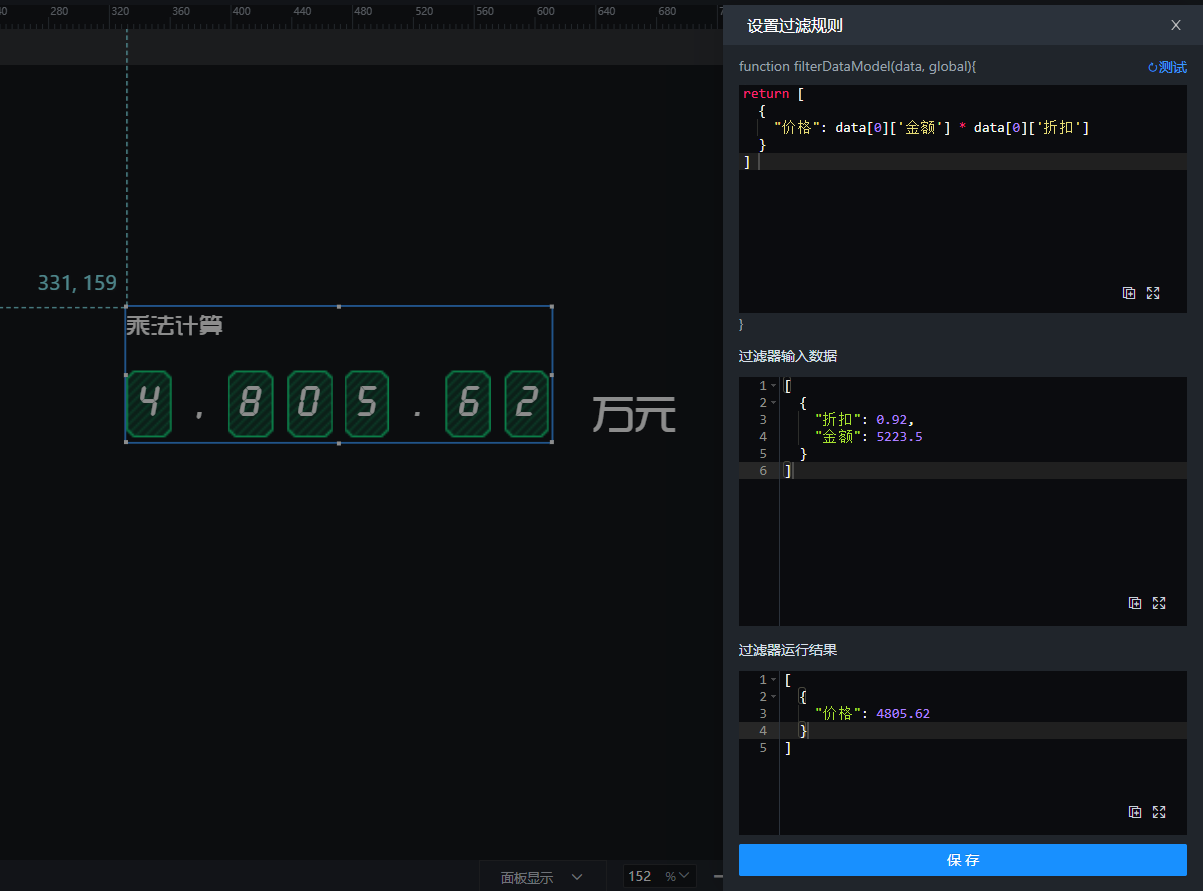
2. 乘法计算
翻牌器需要显示订单的最终价格,数据中返回的是订单金额和折扣数据,可以通过前台过滤器将两个字段做乘法处理。
return [
  {
    "价格": data[0]['金额'] * data[0]['折扣']
  }
] 
3. 格式处理
翻牌器需要显示订单金额,以万元为单位,需要对数据进行万元换算,并保留两位小数。通过前台过滤器处理:
return data.map(d=> ({...d, value2: (+d.value2 / 10000).toFixed(2) })) 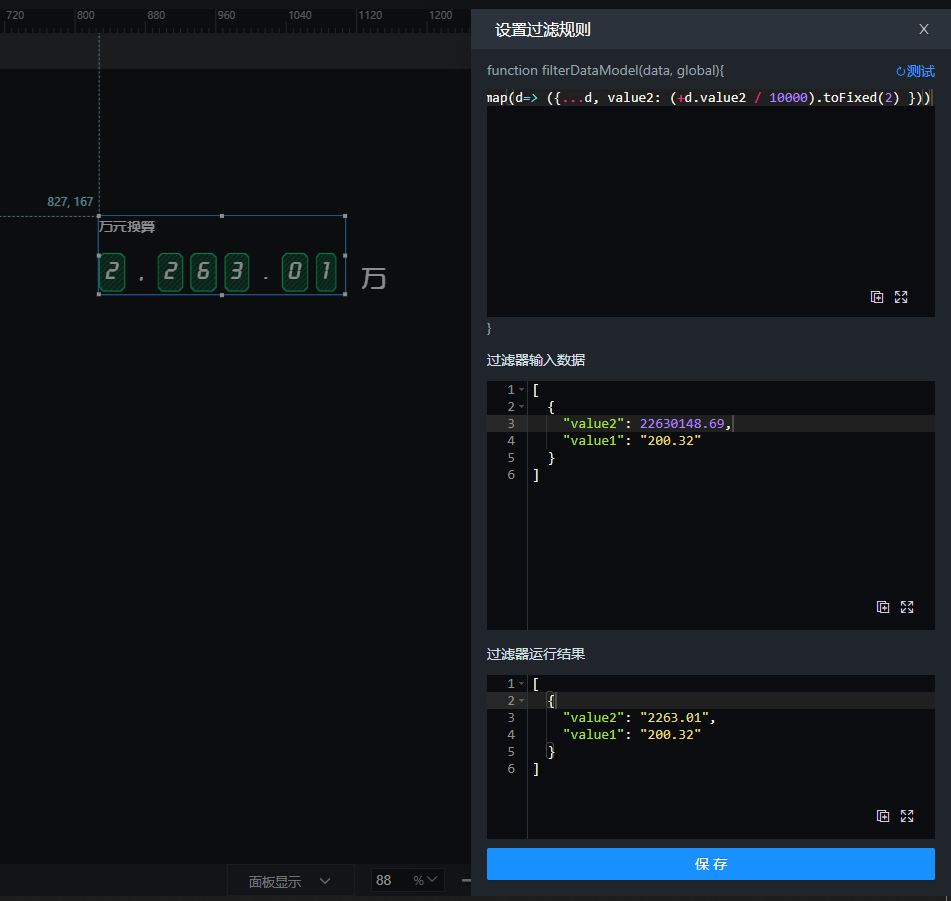
4. 用前端过滤器实现”汇总”和”取某行某列”
前置数据:4 条用户发放记录
来源:资源 → 全局数据 → 数据1(4 条 zhangsan 测试数据),给轮播表格 + 标题 A + 标题 B 共享这一份数据。
| # | USER_ | 金额 | 备注 |
|---|---|---|---|
| 1 | zhangsan | 123,000 | |
| 2 | zhangsan | 12,000 | |
| 3 | zhangsan | 34,000 | |
| 4 | zhangsan | 12,000 |
[
  { "USER_": "zhangsan", "金额": 123000 },
  { "USER_": "zhangsan", "金额": 12000 },
  { "USER_": "zhangsan", "金额": 34000 },
  { "USER_": "zhangsan", "金额": 12000 }
]
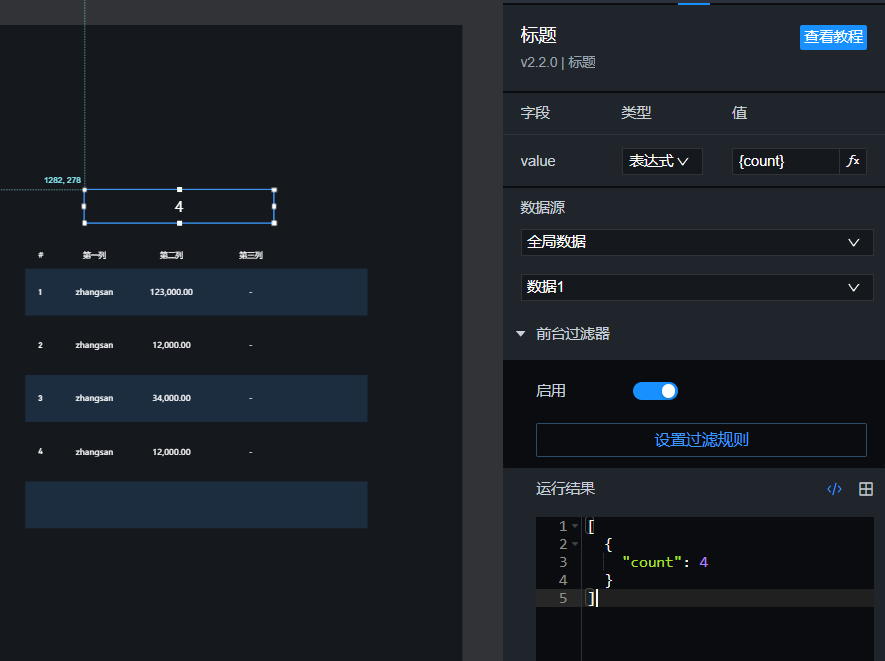
用标题统计”轮播表格内的总记录数”
预期:标题显示 4 · 2 个组件:轮播表格 + 标题 A
效果示意
- 标题 A 显示
4(表达式{count},来自过滤后的[{count: 4}]) - 轮播表格显示 4 行 zhangsan 数据(共享 全局数据 / 数据1)
步骤
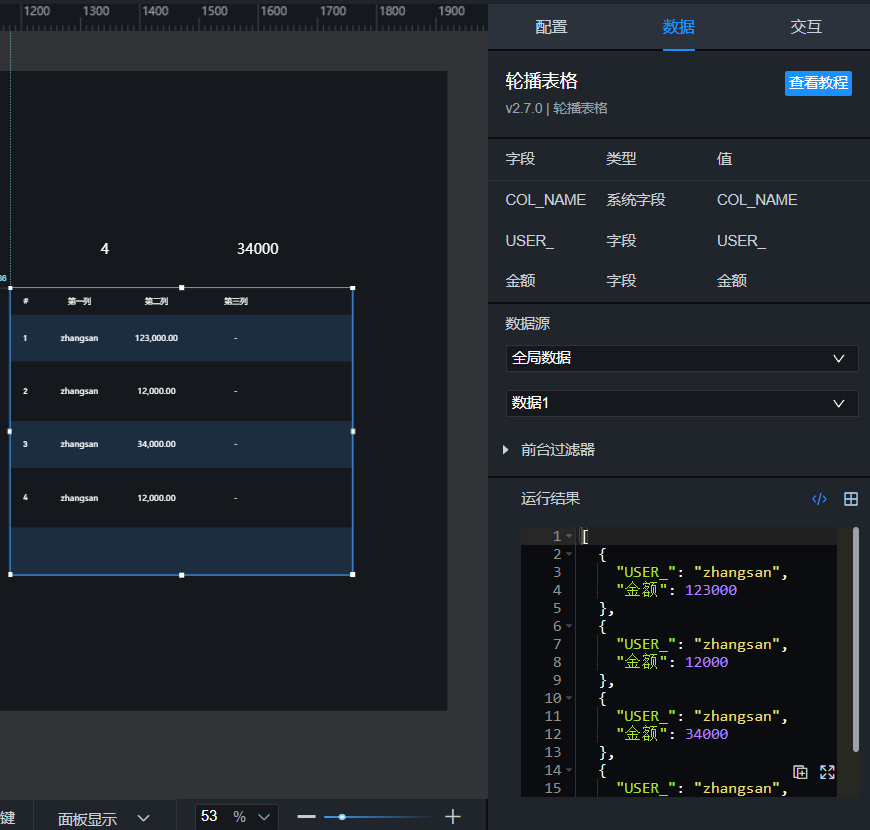
① 在大屏画布上拖一个 轮播表格,数据源选 全局数据 / 数据1,字段映射 USER_ → USER_、金额 → 金额。
② 打开轮播表格的「前台过滤器」,开关 启用,写入:
function filterDataModel(data, global){
  return data.filter(item => item.USER_ == "zhangsan");
}
③ 再拖一个 标题组件,字段 value 类型选 表达式,值写:
{count}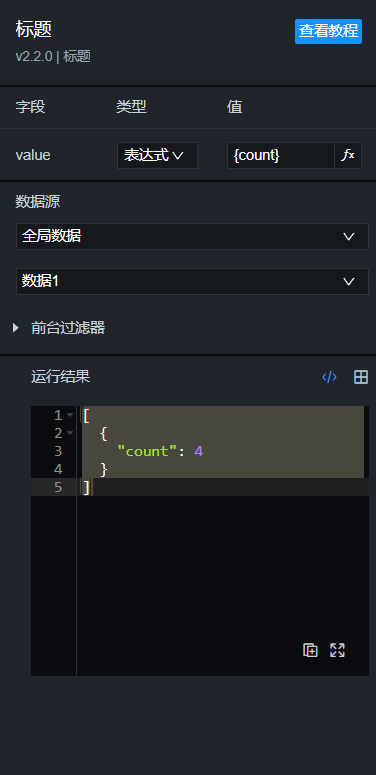
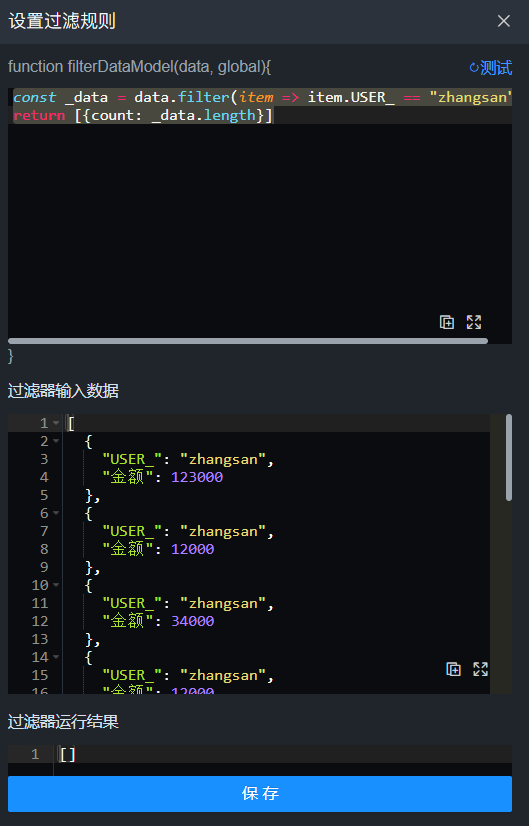
④ 标题组件的数据源也选 全局数据 / 数据1,打开「前台过滤器」开关,核心 JS:
function filterDataModel(data, global){
  const _data = data.filter(item => item.USER_ == "zhangsan");
  // ★ 核心技巧:把"行数"包装成 [{count: _data.length}] 对象数组
  return [{count: _data.length}];
}
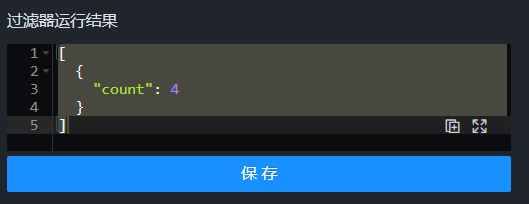
⑤ 点「测试」查看底部「过滤器运行结果」,应显示:
[
  {
    "count": 4
  }
]
结果:标题 A 显示 4,与轮播表格内的 4 行数据一致。
实现原理
- 表达式编辑器不支持
length()函数(或平台表达式没有原生”求数组长度”的函数),所以标题组件没法直接靠表达式算出”总数”。 - 在前端过滤器的 JS 里用
.length算出行数,然后return [{count: ...}]包装成对象数组。 - 标题字段 value 类型选「表达式」,写
{count},平台会用字段引用从返回的对象里取count这个键的值。 - 通用公式:
return [{字段名: 算出来的值}],标题里写{字段名}即可。任何”过滤器侧汇总 + 字段引用”场景都适用。
用标题取”表格内第二列第三行的数据”
预期:标题显示 34000 · 1 个组件:标题 B(轮播表格沿用例 1)
效果示意
- 标题 B 显示
34,000(表达式{金额},来自过滤后的[{USER_:"zhangsan", 金额:34000}]) - 轮播表格第 3 行:zhangsan · 34,000(红框行,索引
i===2)
步骤
① 继续沿用例 1 的轮播表格(数据源 / 过滤器不变)。
② 再拖一个 标题组件,字段 value 类型选 表达式,值写:
{金额}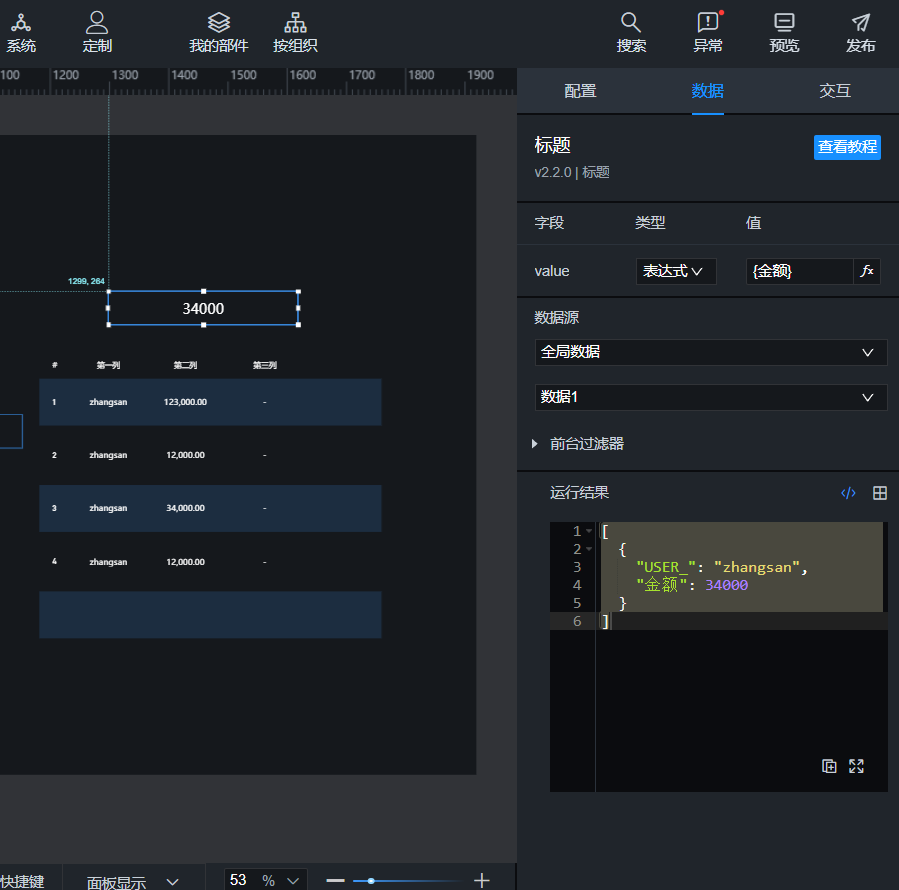
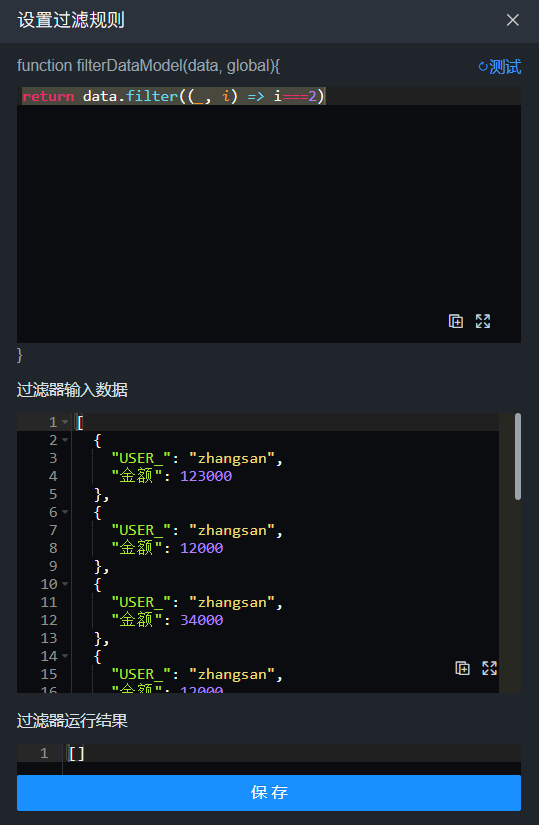
③ 数据源也选 全局数据 / 数据1,打开「前台过滤器」开关,核心 JS:
function filterDataModel(data, global){
  // ★ 核心技巧:用下标索引取第 3 行(数组是 0-indexed,所以 i===2 是第 3 行)
  return data.filter((_, i) => i === 2);
}
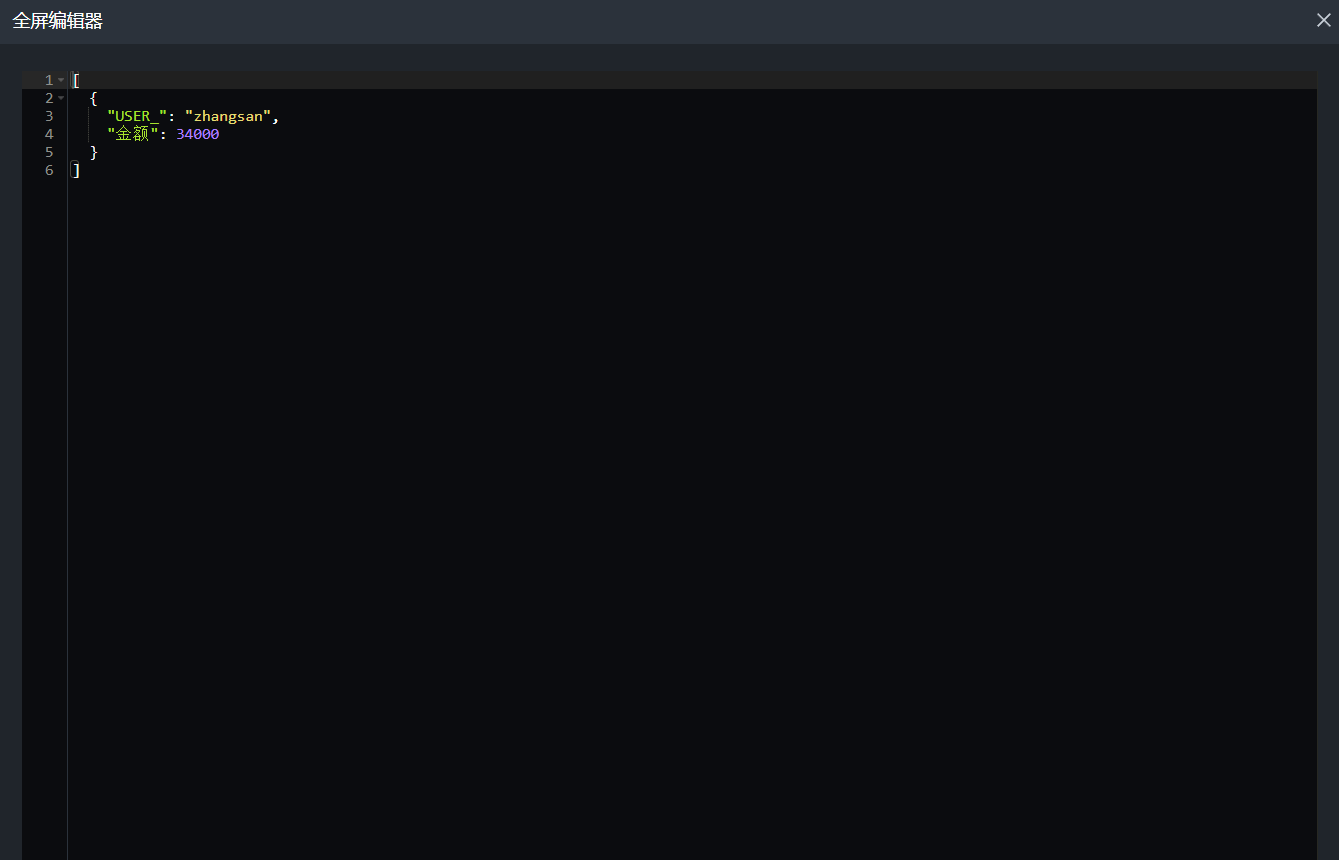
④ 点「测试」查看底部「过滤器运行结果」,应显示:
[
  {
    "USER_": "zhangsan",
    "金额": 34000
  }
]
结果:标题 B 显示 34,000,等于轮播表格第 3 行第二列的值。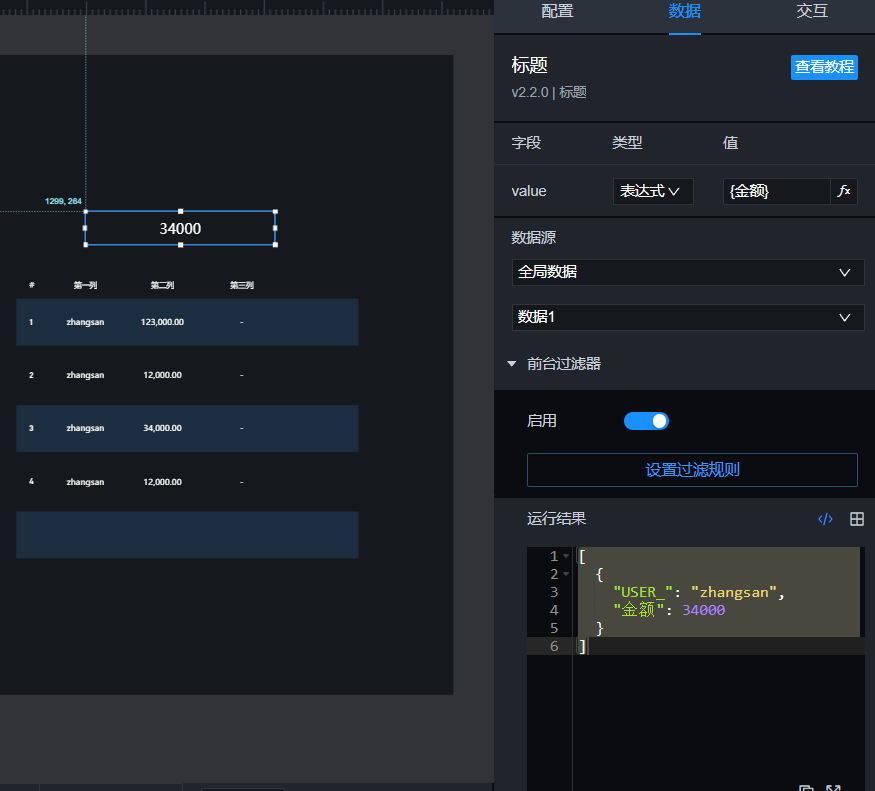
实现原理
- 下标技巧:数组的
filter((_, i) => i === N)是取第N+1行(0-indexed)。要取第 3 行 = 写i === 2。 - 标题表达式
{金额}读”过滤后数组首行的金额字段”——因为过滤后只剩 1 条数据,所以表达式直接读这一条的金额字段。 - 通用公式:前端过滤器筛出 N 行 + 表达式用
{字段名}读首行(适用:取最大 / 取最小 / 取第 N 行 / 唯一一条)。 - 下标取行
i===N写错了最常见的坑是N+1(写i===3想要第 3 行,实际取到第 4 行 12000)。
最后编辑:曾伟峰 更新时间:2026-09-07 15:45
 上一篇:无